In dit artikel
GPT-NL is een Nederlands taalmodel dat TNO, SURF en het Nederlands Forensisch Instituut (NFI) samen bouwen, met geld van het ministerie van Economische Zaken. Het is geen chatbot waar je vandaag een account voor aanmaakt: volgens de projectsite is het model nog alleen beschikbaar voor een kleine groep zogeheten launching customers. De bredere uitrol staat gepland voor de tweede helft van 2026.
Hieronder lees je wat GPT-NL is, wie het betaalt, hoe het getraind is, wat de stand van zaken is op 6 november 2026 en hoe het zich verhoudt tot ChatGPT, Mistral en andere Europese modellen. Wil je eerst weten hoe zo'n model werkt, lees dan wat een LLM is.
Wat is GPT-NL?
GPT-NL is een groot taalmodel (een LLM) voor de Nederlandse taal en context. De makers noemen het "doelgerichte AI": geen universeel model dat alles moet kunnen, maar een model voor zakelijk en domeinspecifiek gebruik, waar soevereiniteit, compliance en controle zwaar wegen. De projectsite noemt als taken samenvatten, vereenvoudigen en retrieval-augmented generation (RAG), waarbij het model antwoorden baseert op documenten van de organisatie zelf.
Het project is een samenwerking van drie non-profitorganisaties: TNO, SURF (het ICT-samenwerkingsverband van onderwijs en onderzoek) en het NFI. De naam lijkt op die van ChatGPT, maar er is geen band met OpenAI. De projectsite waarschuwt ook dat de website gpt-nl.com en het product dat daar wordt verkocht niets met het project te maken hebben. Een taalmodel dat je nu onder een soortgelijke naam kunt afnemen, is dus niet dit model.
Wie betaalt GPT-NL en waarom bestaat het?
De financiering komt van het ministerie van Economische Zaken, via RVO. Volgens de veelgestelde vragen op gpt-nl.nl is het projectplan "Faciliteit voor een soeverein Nederlands taalmodel" in mei 2023 ingediend en eind oktober 2023 gegund. Er is 13,5 miljoen euro beschikbaar gesteld.
De makers noemen vier uitgangspunten: transparant, betrouwbaar, wederkerig en soeverein. In de praktijk betekent dat:
- Rechtmatige data. Het model wordt van nul af aan getraind ("from scratch"), zodat het geen auteursrechtschendingen of persoonsgegevens erft van eerdere modellen. Data mag alleen mee als de aanbieder de rechten heeft om die te licenseren.
- Transparantie. De makers publiceren de broncode en de data die ze mogen vrijgeven, en zijn open over keuzes tijdens de training.
- Wederkerigheid. Een deel van de opbrengsten gaat terug naar de auteursrechthebbenden. Zij zitten in de Content Board en hebben inspraak over de toekomst van het model.
- Soevereiniteit. Het model is op Nederlandse bodem gebouwd en blijft in Nederlandse handen, zodat organisaties minder afhankelijk zijn van buitenlandse big tech.
Waarop is GPT-NL getraind?
De trainingsdata bestaat uit gelicentieerde data van partijen in de Content Board, openbare data en data die met uitdrukkelijke toestemming is ingebracht. Voor de openbare data is een extract van Common Crawl gemaakt met alleen CC-BY- en CC-0-licenties, samen met het Instituut voor de Nederlandse Taal. Daarnaast is er synthetische data en code. Volgens de projectsite is het model getraind op de supercomputer Snellius, met een start van 370 miljard unieke tokens. De hoeveelheid synthetische data is beperkt: rond 5 miljard tokens, minder dan een procent van het totaal.
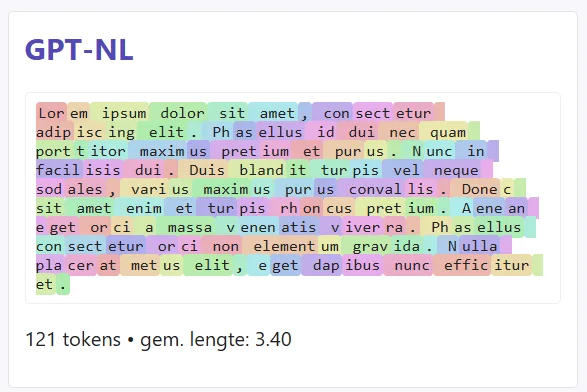
Er zijn vijf criteria voor de dataset: bescherming van intellectueel eigendom, geen persoonsgegevens (behalve van publieke personen, voor basiskennis), geen vertrouwelijke informatie zoals patiëntgegevens, geen schadelijke inhoud en zo min mogelijk duplicaten. Het model heeft ook een eigen tokenizer, het onderdeel dat tekst in stukjes hakt. Die kent 128.000 woorden en woorddelen, waarvan ongeveer 40 procent Nederlands, en splitst Nederlandse samenstellingen als "koffiezetapparaat" logischer dan veel andere tokenizers.
Wat is de status van GPT-NL in november 2026?
De kop op gpt-nl.nl luidt "Najaar 2026: GPT-NL v.1". Dit is wat de officiële pagina's zeggen:
| Onderdeel | Stand volgens gpt-nl.nl |
|---|---|
| Training | Gestart in Q3 2025, daarna finetuning |
| Eerste gebruikers | Sinds februari 2026 werken launching customers met het model in feasibility studies van 3 tot 6 maanden |
| Laatste nieuws | 19 oktober 2026: feasibility study met PNA Group |
| Brede uitrol | Verwacht in de tweede helft van 2026, met een professionele licentie en later een gehoste versie |
| Prijs | Nog niet bekend: licentiekosten en tarief per gebruik worden bij de brede uitrol bekendgemaakt |
Voor zover wij konden nagaan, staat er op 6 november 2026 geen officiële aankondiging dat het model breed beschikbaar is. De laatste update op de projectsite is van 19 oktober. Je kunt het dus nog niet zomaar afnemen, en er is ook geen publieke chat-app. Check voor de actuele stand de nieuwspagina op gpt-nl.nl.
De feasibility studies laten zien waar het model naartoe gaat. De KB nationale bibliotheek bouwt een RAG-assistent op de rechtenvrije Delpher-collectie. PNA Group test het model in HIP, een assistent die ambtenaren helpt overheidsbrieven begrijpelijker te maken. Verder noemt de projectsite onder meer de gemeentelijke chatbot Gem, een digitale assistent van het ministerie van Binnenlandse Zaken, interne toepassingen bij TNO en forensisch onderzoek bij het NFI. Voor zo'n studie draait de organisatie het model zelf, op eigen servers, en betaalt ze mee aan de doorontwikkeling.
Hoe open is GPT-NL?
Minder open dan de naam doet vermoeden. De broncode staat op GitHub en het publieke deel van de data is vrijgegeven. De gewichten van het model, de getrainde getallen waar het model uit bestaat, krijg je alleen op verzoek en onder een licentie. Voor onderzoek is dat bijna gratis na registratie (de makers onderzoeken nog wat de staatssteunregels precies toestaan). Voor commercieel gebruik komt er een professionele licentie met een vergoeding. De makers leggen uit dat de subsidievoorwaarden eisen dat de kosten voor instandhouding worden terugverdiend, en dat ze moeten weten wie het model afneemt om afnemers te kunnen waarschuwen als er na een opt-outverzoek een nieuw model komt. Daarom noemen ze het model zelf ook bewust niet volledig open source.
GPT-NL vergeleken met ChatGPT, Mistral en andere modellen
Een eerlijke vergelijking begint met het verschil in doel. ChatGPT is een kant-en-klare app voor iedereen, gebouwd op modellen van de grootste AI-bedrijven. Mistral is een Frans bedrijf met een eigen chat-app en open modellen, waaronder het recente Mistral Large 4 met 1 biljoen parameters. GPT-NL is een bouwsteen voor organisaties met strenge eisen aan data, geen product voor de losse gebruiker.
| GPT-NL | ChatGPT | Mistral | |
|---|---|---|---|
| Maker | TNO, SURF, NFI (non-profit) | OpenAI | Mistral AI (Frankrijk) |
| Voor wie | Launching customers, later organisaties met licentie | Iedereen, ook gratis | Iedereen, ook via API en open modellen |
| Trainingsdata | Gelicentieerd en open, met openbare datakeuzes | Niet volledig openbaar | Niet volledig openbaar |
| Zelf hosten | Ja, de feasibility studies draaien on-premise | Nee | Ja, bij open modellen |
| Kosten | Nog niet bekend | Gratis en betaalde abonnementen | Gratis en betaald |
Op kwaliteit moet je realistisch zijn. De makers zeggen zelf dat de basis van het model op redeneren en kennisgebieden die weinig in hun data voorkomen nog niet de resultaten van andere LLM-initiatieven haalt: bij de HellaSwag-test zitten ze dichter bij Llama 2 7B. Bij taken als samenvatten, sentimentanalyse en begrijpend lezen komen ze in de buurt van Llama 2 13B of 70B en Olmo-2 32B. Qua grootte en architectuur vergelijken ze het model met Gemma3-27B. Die cijfers komen van het project zelf, zijn niet definitief en gaan over een model dat flink kleiner is dan de nieuwste topmodellen zoals Mistral Large 4. Verwacht van GPT-NL dus geen concurrent van de grootste modellen op lastige redeneertaken. Het is bedoeld als degelijk, controleerbaar werkpaard voor Nederlandse tekst.
GPT-NL ziet zichzelf als aanvulling op andere Europese initiatieven zoals EuroLLM en TrustLLM, en TNO werkt mee aan meerdere Europese projecten. Zoek je alternatieven voor een specifiek model, kijk dan ook in de vergelijking van Claude-alternatieven.
Wat betekent GPT-NL voor jou of je organisatie?
Voor de meeste professionals verandert er voorlopig niets. Je gebruikt nog gewoon ChatGPT, Claude, Gemini of Mistral. Interessant wordt GPT-NL voor organisaties die:
- gevoelige gegevens hebben en het model liever op eigen servers draaien dan in de cloud van een Amerikaans bedrijf;
- willen kunnen aantonen waarop een model is getraind, bijvoorbeeld omdat ze onder de AI Act en de AVG vallen;
- werken met Nederlandse overheidstaal, zoals brieven, loketvragen of archieven;
- zelf een technisch team hebben dat een model kan installeren en koppelen aan eigen documenten.
Ben je een zzp'er of klein bedrijf zonder eigen IT, dan heb je er voorlopig weinig aan. Wacht tot de gehoste versie en de prijzen bekend zijn. Een overzicht van wat je nu al in Nederland kunt gebruiken, komt in de gids met Nederlandse AI-tools.
Veelgestelde vragen
Is GPT-NL al beschikbaar?
Nog niet voor het grote publiek. Volgens gpt-nl.nl is het model voorlopig alleen beschikbaar voor launching customers. De bredere uitrol is gepland voor de tweede helft van 2026, en we vonden op 6 november 2026 geen officiële aankondiging dat die al is gestart.
Kan ik GPT-NL gratis gebruiken, zoals een Nederlandse ChatGPT?
Er is geen gratis chat-app. Voor onderzoek worden de gewichten tegen een nominale vergoeding aangeboden, voor commercieel gebruik komt een betaalde professionele licentie. De prijzen worden bij de brede uitrol bekendgemaakt.
Wie bouwt GPT-NL en wie betaalt het?
TNO, SURF en het NFI bouwen het, als non-profit. Het ministerie van Economische Zaken financiert het via RVO, met 13,5 miljoen euro.
Is GPT-NL open source?
Gedeeltelijk. De broncode is open source en het publieke deel van de data is vrijgegeven. De modelgewichten zijn alleen op verzoek en onder licentie beschikbaar.
Is GPT-NL beter dan ChatGPT?
Voor algemeen gebruik niet, en zo wordt het ook niet gepositioneerd. De makers zeggen zelf dat het model op redeneren achterblijft bij andere initiatieven. De kracht zit in herkomst van de data, controle en Nederlandse taal.
Bronnen
Eindredactie: Jan van Musscher, hoofdredacteur · Zo werken we